Află că site-ul a căzut înaintea clienților tăi.
Opt tipuri de verificări, la intervale de la 30 de secunde. Reverificăm de până la 3 ori înainte să te anunțăm, ca să nu te trezim degeaba.
Pe scurt
- 8 tipuride verificări, de la HTTP la heartbeat
- de la 30 sinterval minim, pe Echipă și peste
- Până la 3reverificări la 10 s, înainte de incident
- Frankfurtregiuni noi în curând
01Tipuri de verificări
Opt tipuri de verificări, într-un singur formular
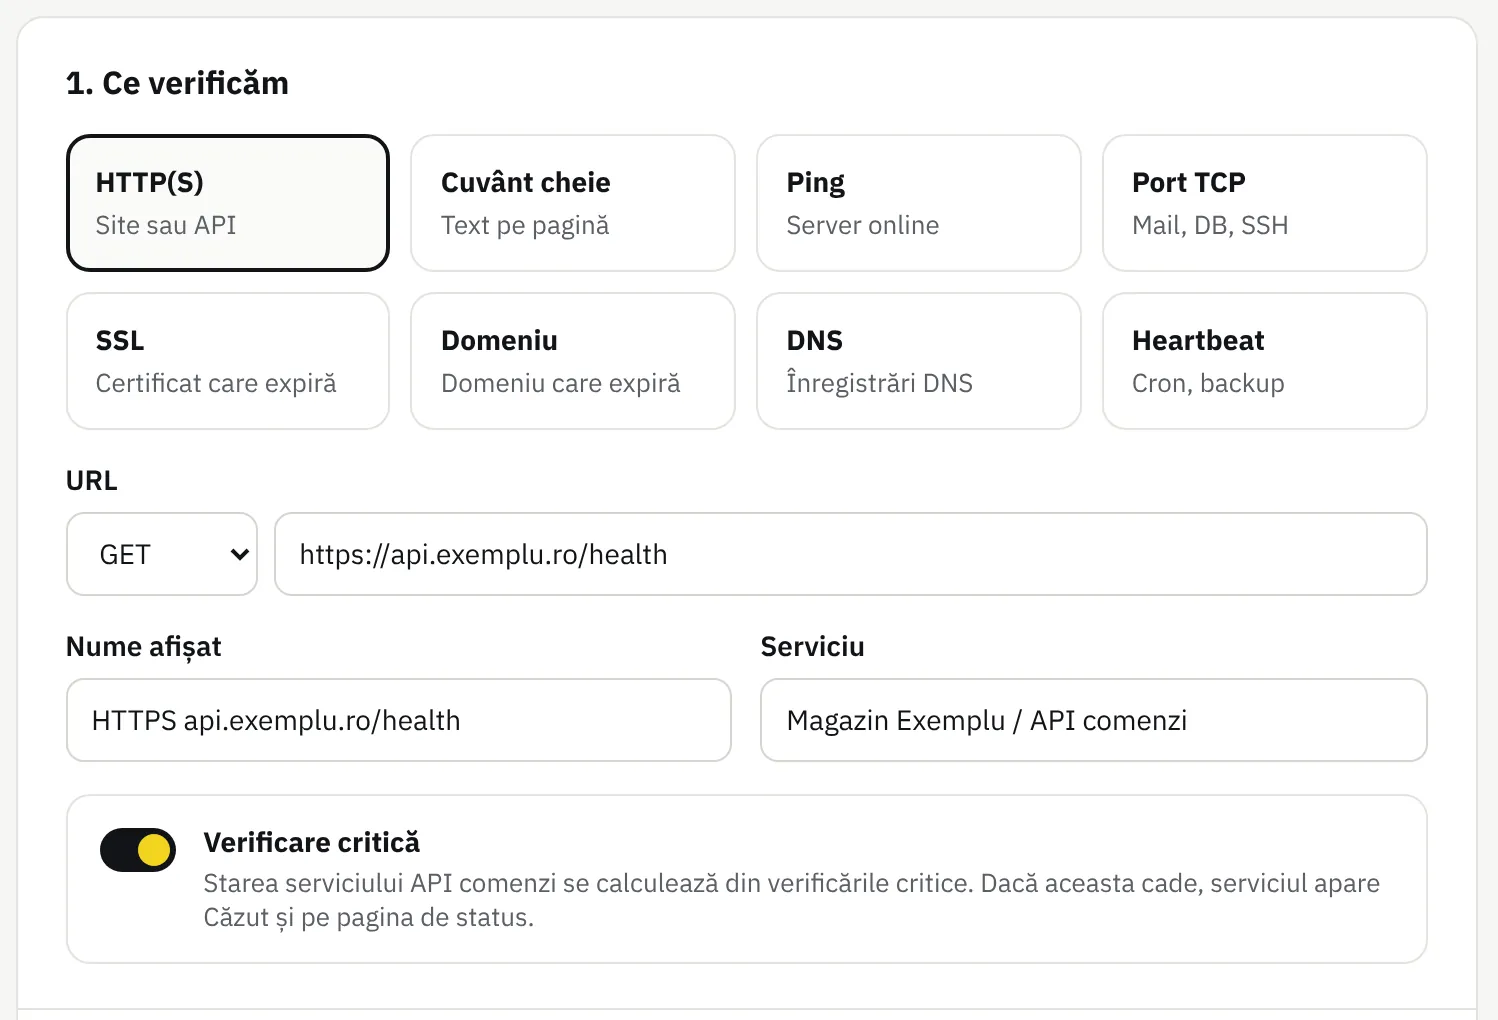
Alegi ce verificăm, pui adresa și gata. Același formular pentru un site, un API, un port de bază de date sau jobul de backup de la 3 noaptea.
- Ce faci
- Alegi tipul, adresa și serviciul din care face parte verificarea.
- Ce vezi
- „Test rapid” rulează o verificare pe loc, din Frankfurt, și îți arată ce a răspuns serverul tău.
- Ce primești
- O verificare care pornește imediat și intră în starea serviciului dacă e critică.
-
HTTP(S)
Site-uri și API-uri: cod de stare, timp de răspuns, antete. GET, HEAD sau POST.
-
Cuvânt cheie
Un text care trebuie să apară sau să lipsească, ex. „Adaugă în coș”.
-
Ping
Serverul e online: latență și pierdere de pachete.
-
Port TCP
Mail, baze de date, SSH: orice serviciu care ascultă pe un port.
-
SSL
Certificatul și data la care expiră, cu alerte din timp.
-
Domeniu
Data de expirare din registru, cu mementouri.
-
DNS
Alertă când o înregistrare A, MX sau CNAME nu mai are valoarea așteptată.
-
Heartbeat
Cron și backup-uri: dacă scriptul tău tace, primești alertă.
HTTP(S), cuvânt cheie, ping și port TCP sunt pe toate planurile; SSL, domeniu, DNS și heartbeat, pe Start și peste.
02Intervale și confirmare
Verificat de la 30 de secunde, confirmat de până la 3 ori
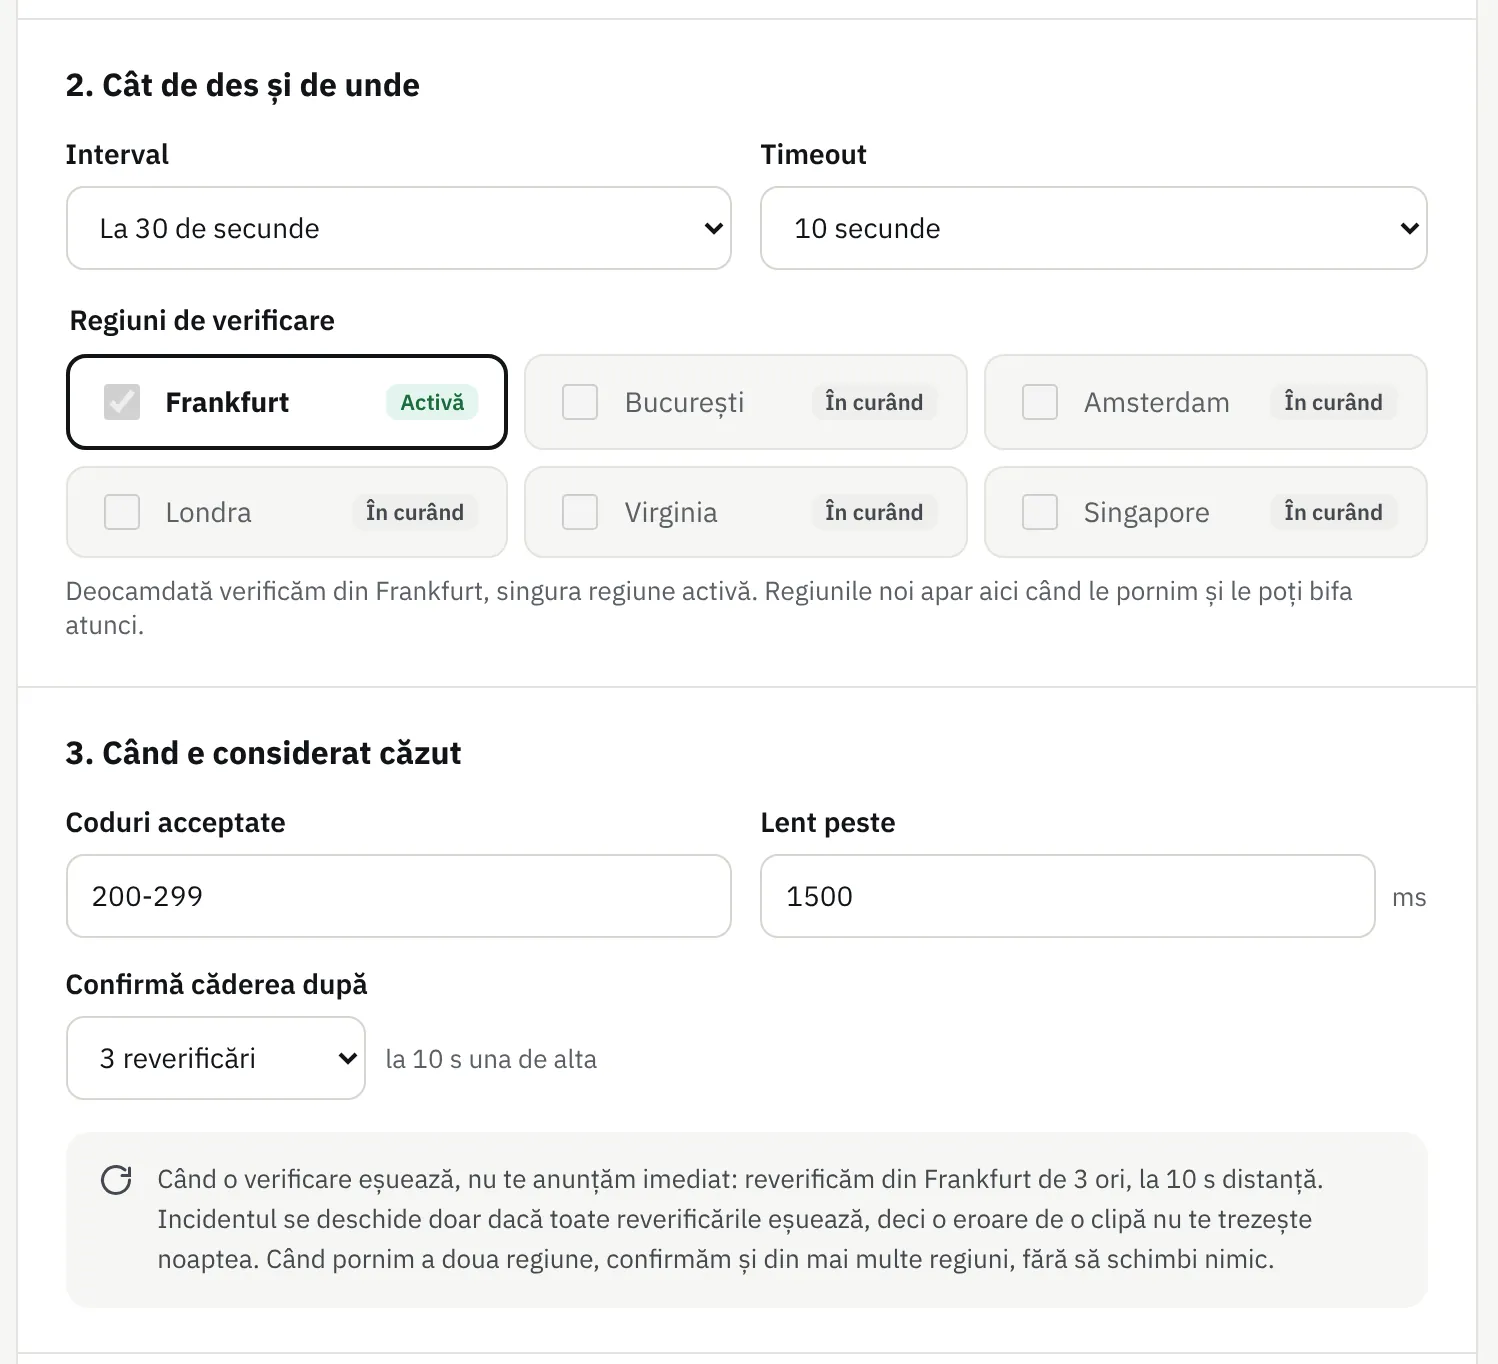
Un timeout izolat pe drum nu e o cădere. La prima eroare reverificăm de până la 3 ori, la 10 secunde distanță, și deschidem incidentul doar dacă eroarea se repetă de fiecare dată.
- Ce faci
- Alegi intervalul dintre cele ale planului (Gratuit la 5 min, Start la 1 min, Echipă la 30 s, Agenție la 30 s), timeout-ul, codurile acceptate, numărul de reverificări și pragul „Lent peste”.
- Ce vezi
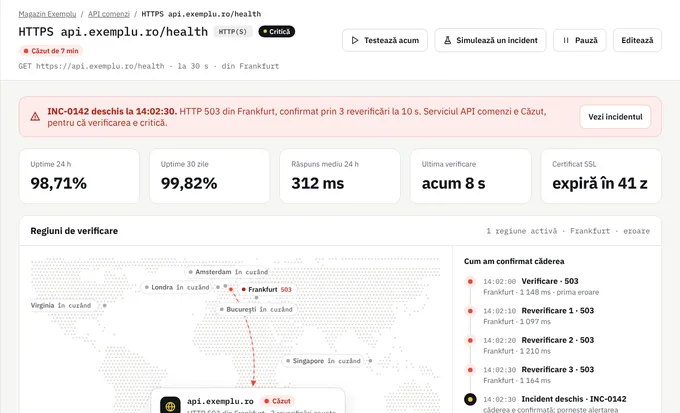
- Regiunile de verificare: Frankfurt e activă și bifată; celelalte apar „În curând”.
- Ce primești
- Cu 3 reverificări, un incident la circa 30 de secunde după prima eroare, nu o alarmă la fiecare sughiț. Un răspuns peste prag e marcat „Lent”; serviciul devine Degradat doar când majoritatea răspunsurilor din ultimele 5 minute trec de prag.
- 14:02:00Verificare · HTTP 503, prima eroare
- 14:02:10Reverificare 1 · 503 · serviciul arată „Se reverifică”
- 14:02:20Reverificare 2 · 503
- 14:02:30Reverificare 3 · 503
- 14:02:30Incident deschis · pornește alertarea
03Servicii și verificări critice
Gândești în servicii, nu în URL-uri
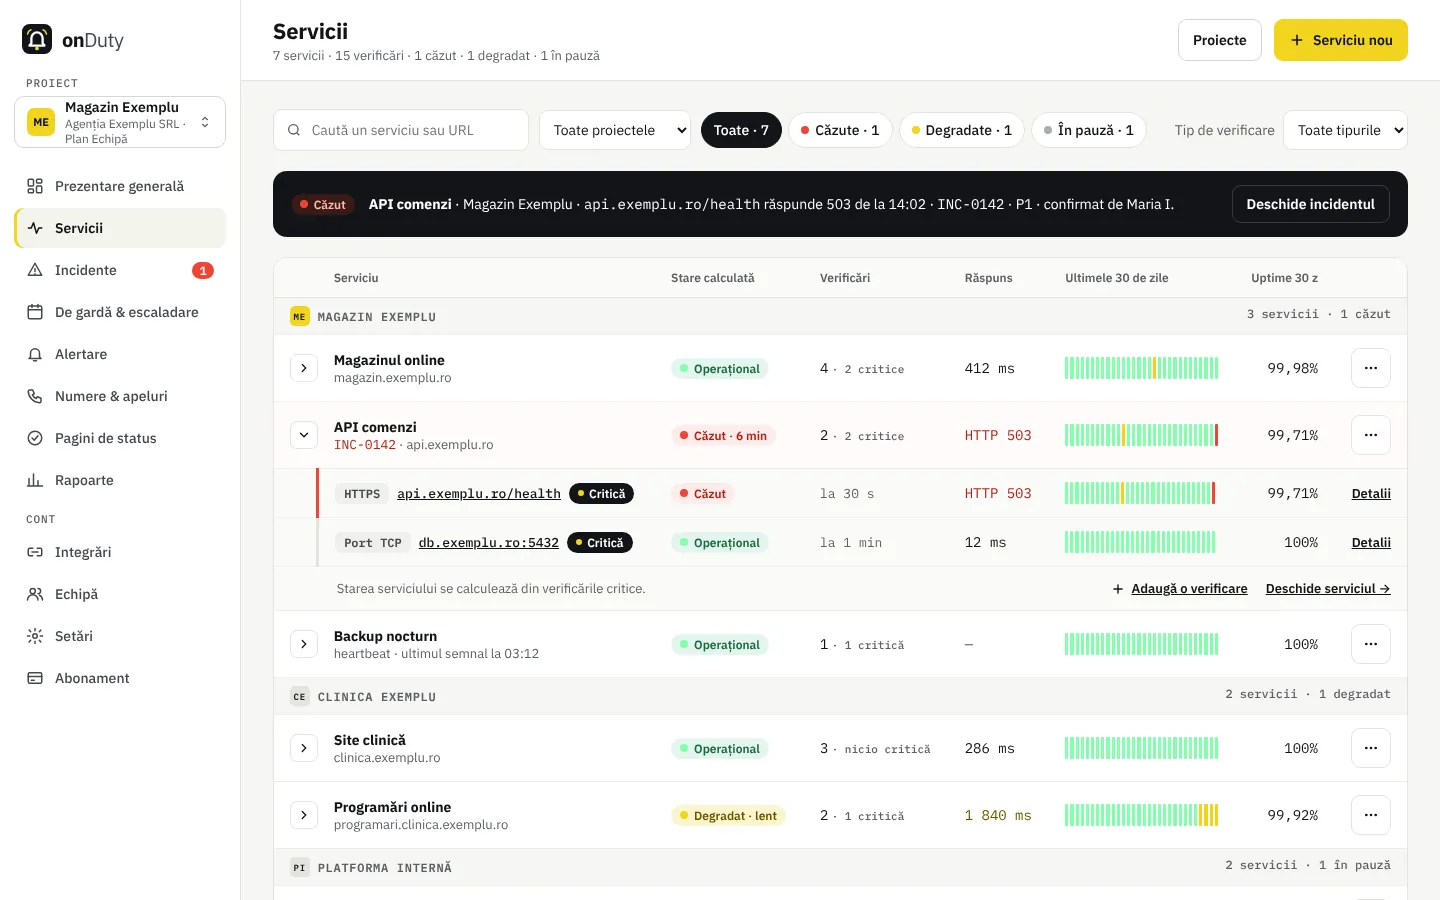
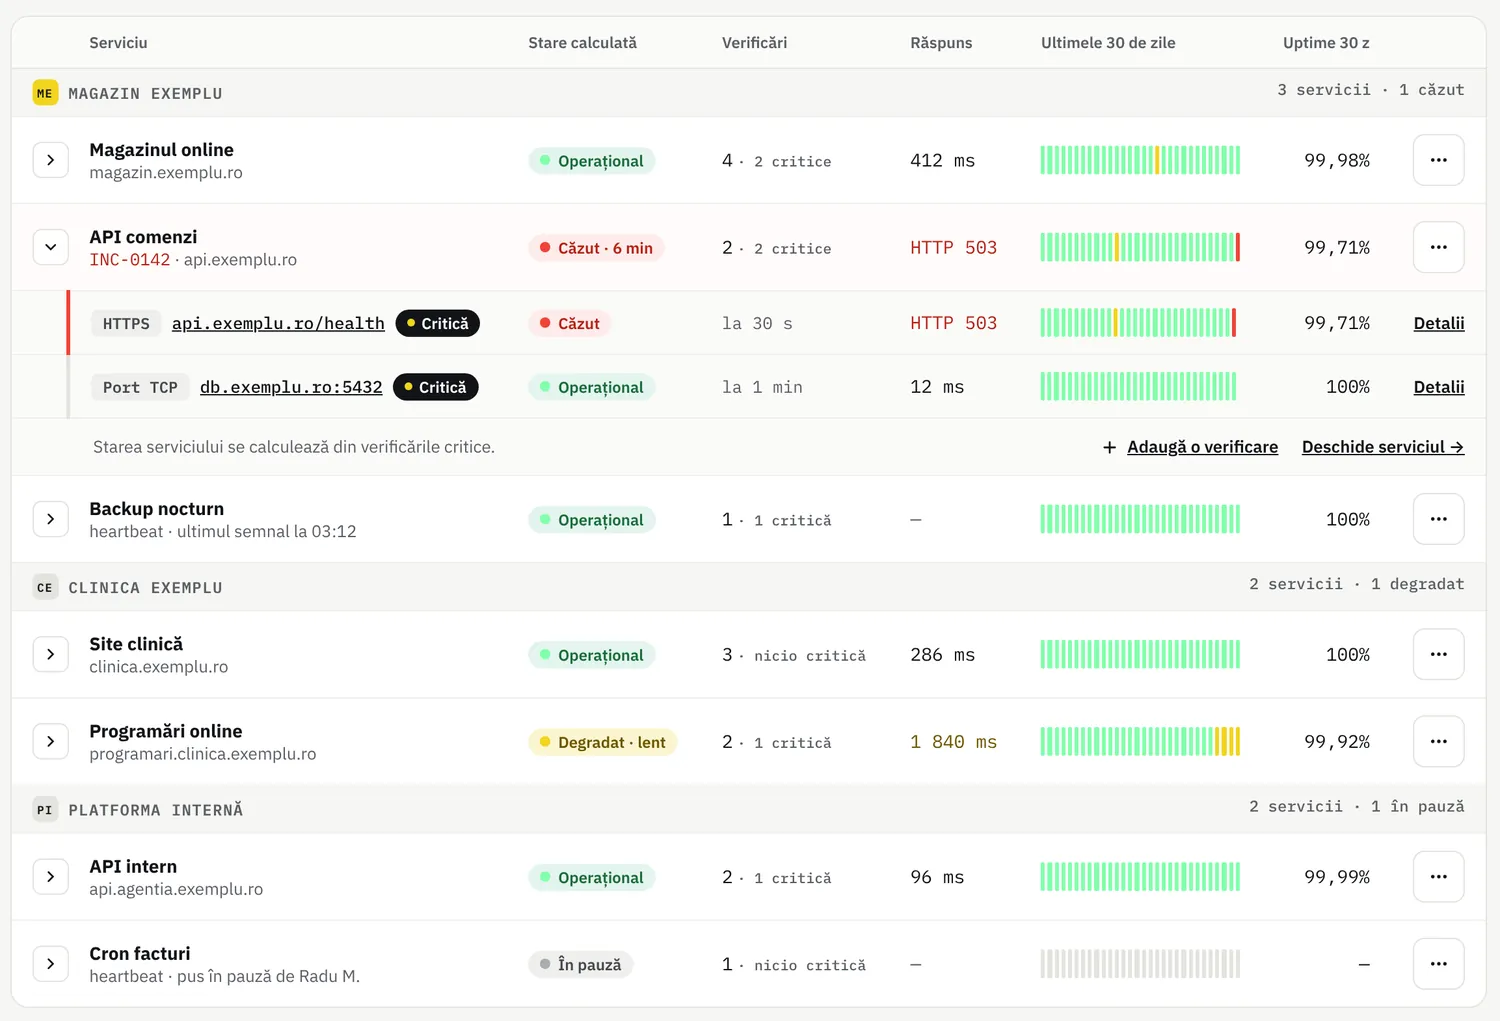
Un serviciu e aplicația pe care o folosesc clienții: „Magazinul online”, „API comenzi”. Îi pui câte verificări vrei și alegi care dintre ele sunt critice.
- Ce faci
- Grupezi verificările pe servicii și proiecte; o verificare nouă e critică implicit, până oprești comutatorul „Verificare critică”.
- Ce vezi
- Starea serviciului = cea mai gravă stare dintre verificările critice: Căzut, apoi Degradat, apoi Operațional.
- Ce primești
- O listă care spune ce e stricat pentru client. Verificările necritice își arată starea în consolă, dar nu deschid incidente și nu schimbă starea serviciului sau pagina de status.
04Detaliul verificării
Vezi exact ce a răspuns și când
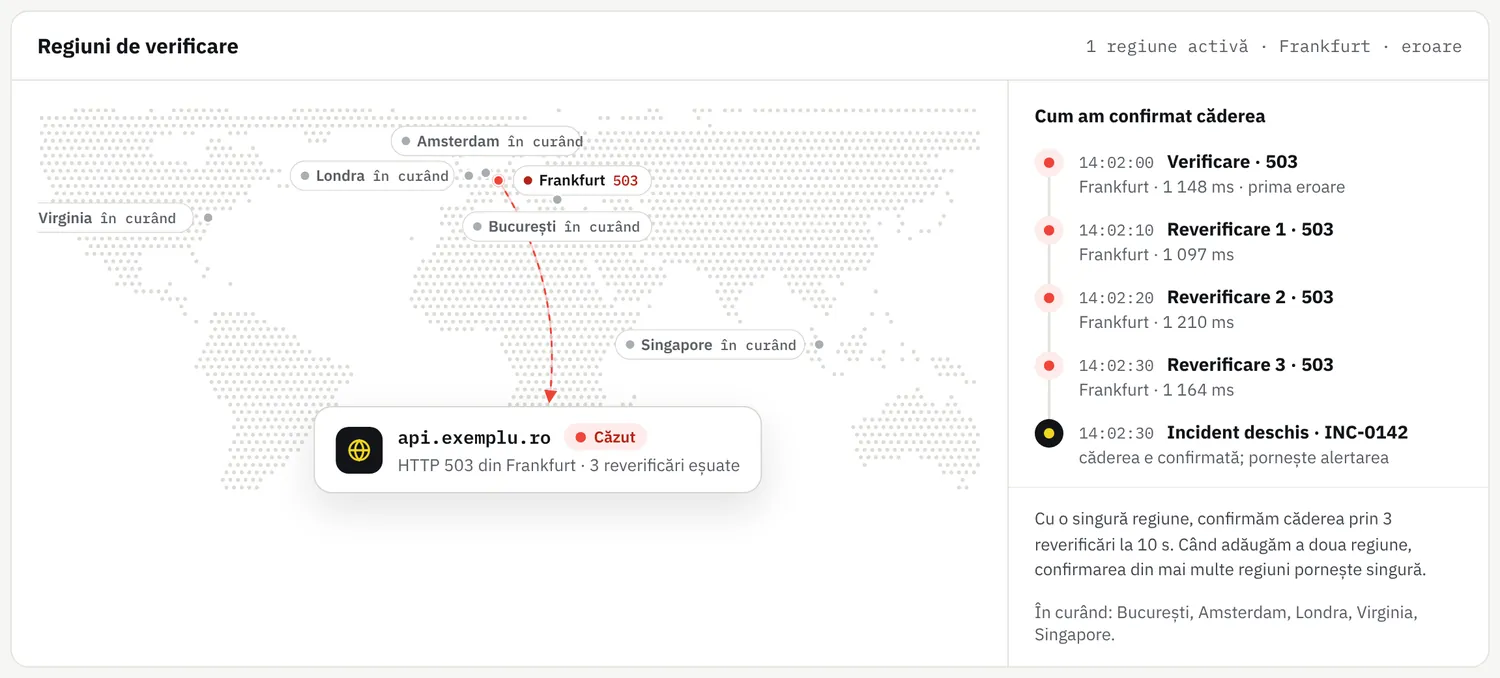
Fiecare verificare are pagina ei: uptime, timpul de răspuns, regiunea și cronologia confirmării, cu fiecare reverificare la secundă.
- Ce faci
- Deschizi verificarea din serviciu sau din incident.
- Ce vezi
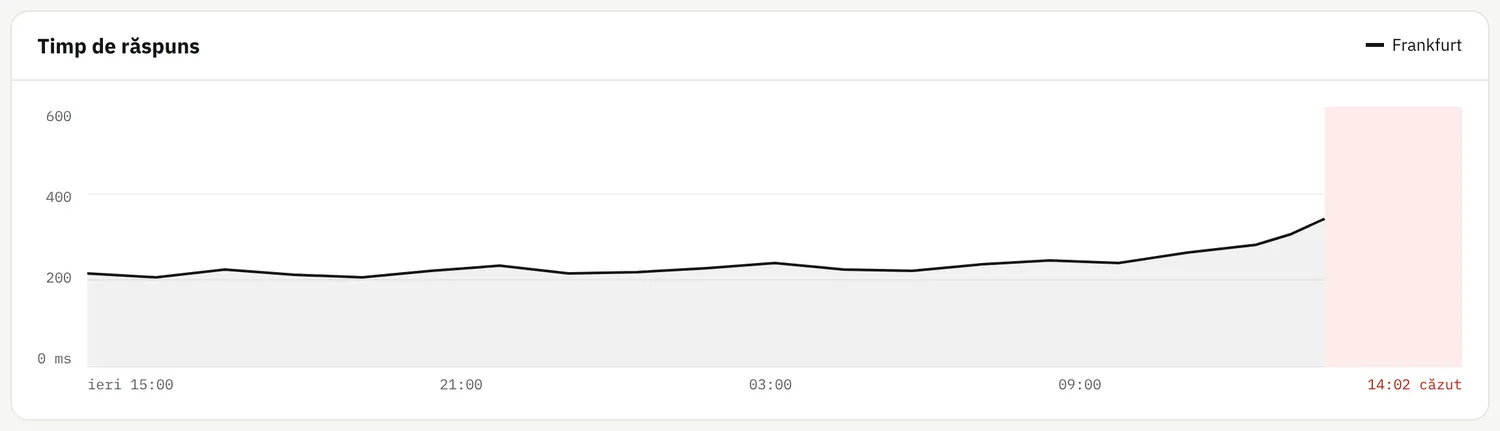
- Regiunile de verificare cu felul în care am confirmat căderea, graficul timpului de răspuns cu banda roșie a căderii și ultimele verificări, cu codul și durata.
- Ce primești
- Dovada pentru client sau pentru furnizorul de hosting: ce eroare, de unde, la ce oră.
Azi verificăm din Frankfurt. Când pornește a doua regiune, confirmarea din cel puțin 2 regiuni se face automat, fără să schimbi nimic la verificările tale.
05SSL, domeniu și heartbeat
Certificatul și domeniul nu mai expiră pe nepusă masă
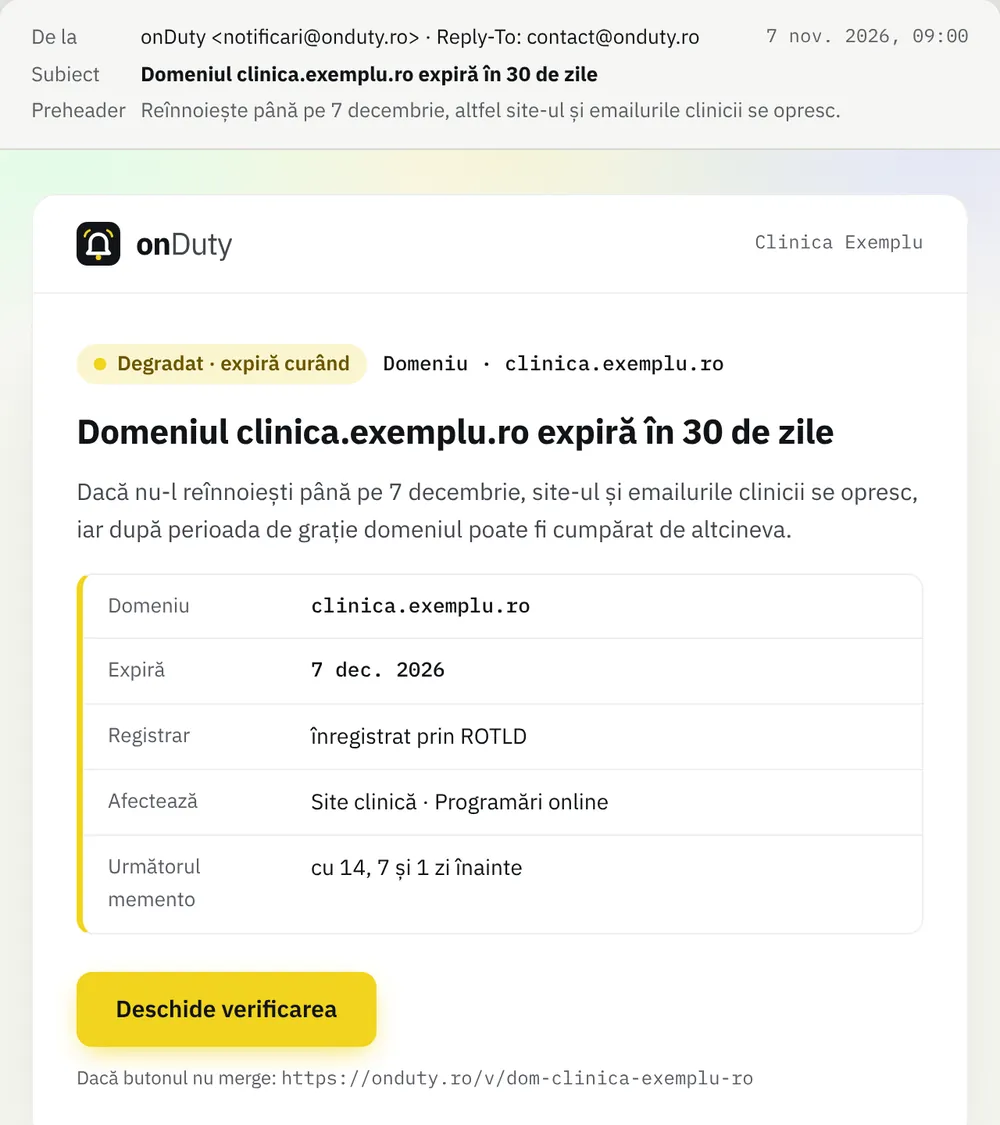
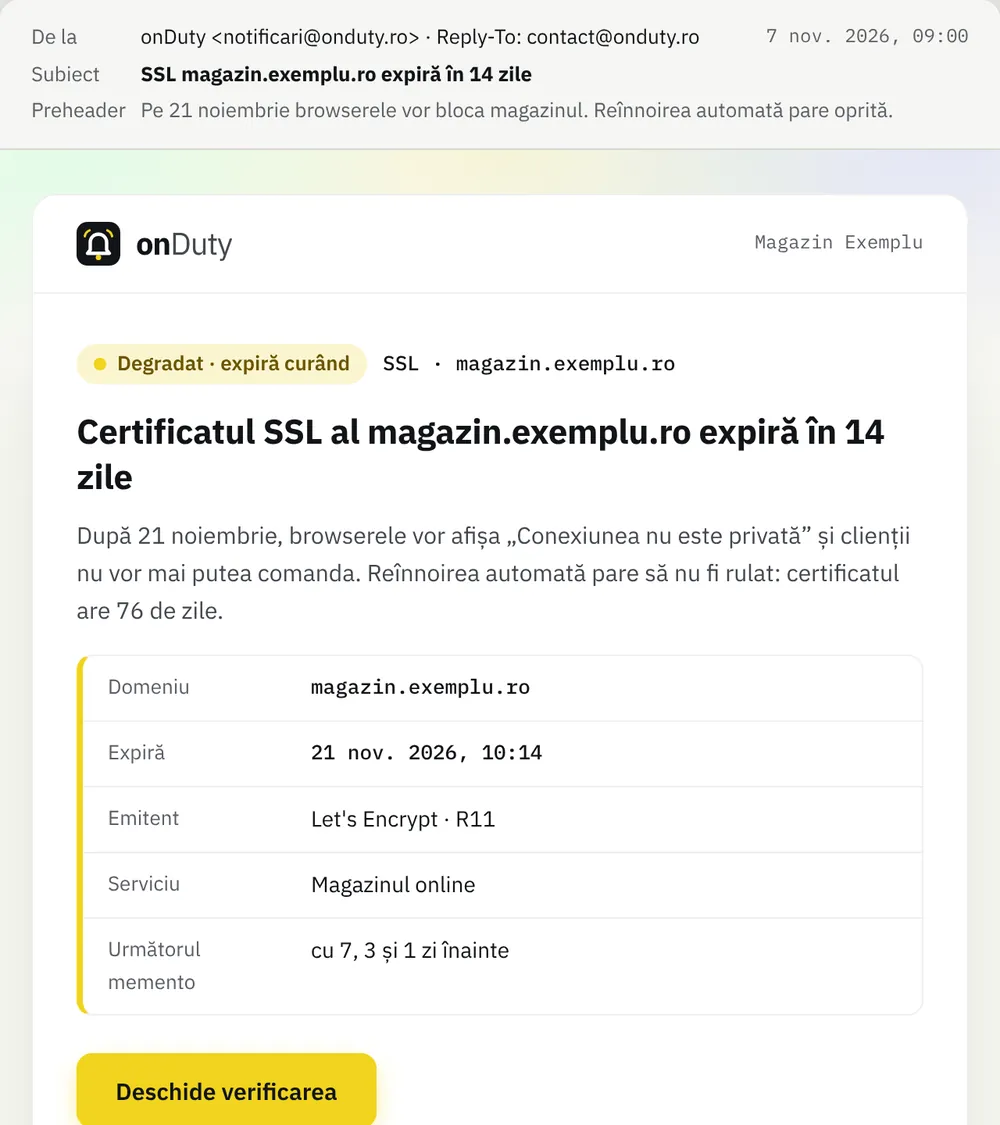
Reînnoirea automată se strică fără zgomot. Verificările SSL și Domeniu urmăresc data de expirare și te anunță din timp, cu mementouri până în ultima zi.
- Ce faci
- Adaugi o verificare SSL sau Domeniu; pentru joburi cron pui un heartbeat (
onduty.ro/hb/…) la finalul scriptului. - Ce vezi
- Câte zile mai are certificatul, cine l-a emis și ce servicii sunt afectate.
- Ce primești
- Email cu data exactă și următorul memento; dacă jobul de backup nu trimite semnalul la timp, se deschide un incident.
Verificările SSL, Domeniu, DNS și Heartbeat sunt pe Start și peste.
06Mentenanță și pagina de status
Lucrări planificate, fără alarme
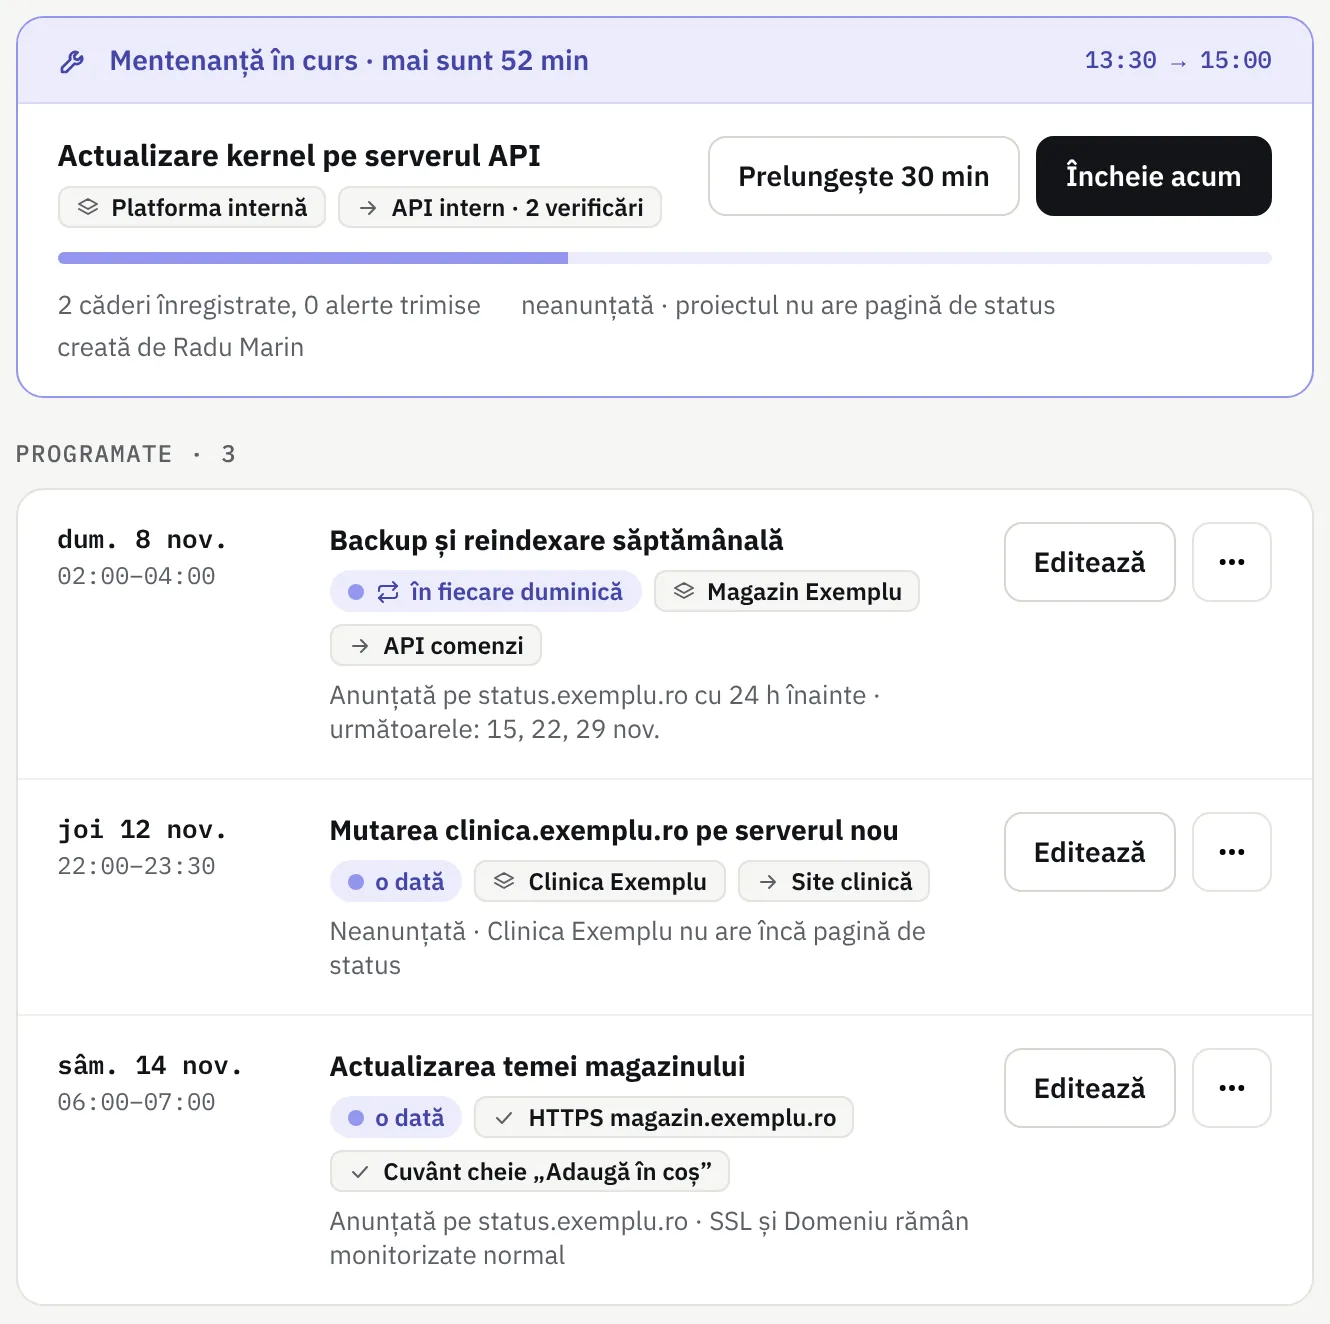
Programezi o fereastră o dată sau recurent, pe un proiect, un serviciu sau doar pe anumite verificări. Clienții văd anunțul pe pagina de status.
- Ce faci
- Alegi fereastra, ce acoperă și cu câte ore înainte apare anunțul pe pagina de status.
- Ce vezi
- Verificările rulează și se înregistrează, dar nu deschid incidente și nu sună pe nimeni. Componenta trece pe „Mentenanță” cât ține fereastra.
- Ce primești
- Uptime corect: timpul din fereastră nu îl scade. Dacă ceva e tot căzut la final, incidentul se deschide normal.
Cum arată în practică
Marți, 14:02. API-ul de comenzi răspunde 503.
Așa arată aceeași cădere în onDuty, de la prima eroare până la revenire. Clienții află de pe pagina de status, echipa din telefon.
- Până la incident
- 30 s
- Reverificări
- 3
- Căzut în total
- 29 min
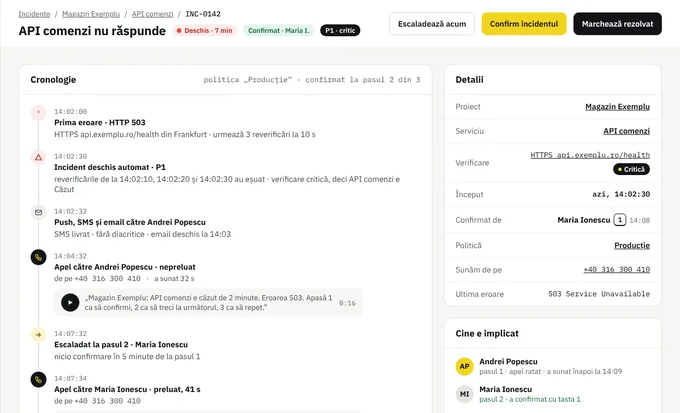
- 14:02:00Verificareapi.exemplu.ro/health răspunde HTTP 503 din Frankfurt
- 14:02:10ReverificareTrei reverificări la 10 s · serviciul arată „Se reverifică”, fără incident
- 14:02:30IncidentINC-0142 deschis · verificare critică, deci „API comenzi” e Căzut
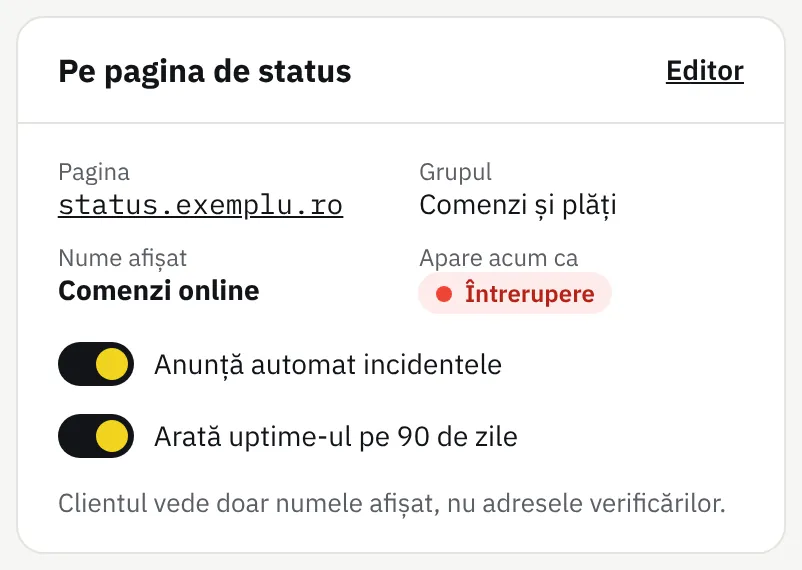
- 14:02:30Statusstatus.exemplu.ro trece componenta „Comenzi online” pe Întrerupere
- 14:02:32Push · SMSAndrei Popescu, de gardă, primește push, SMS și email
- 14:08:15ApelMaria Ionescu confirmă cu tasta 1 · escaladarea se oprește
- 14:31:10RezolvatRevenire confirmată prin reverificări · incidentul se închide singur
Merge mână în mână cu
Funcționează împreună
Monitorizare servere
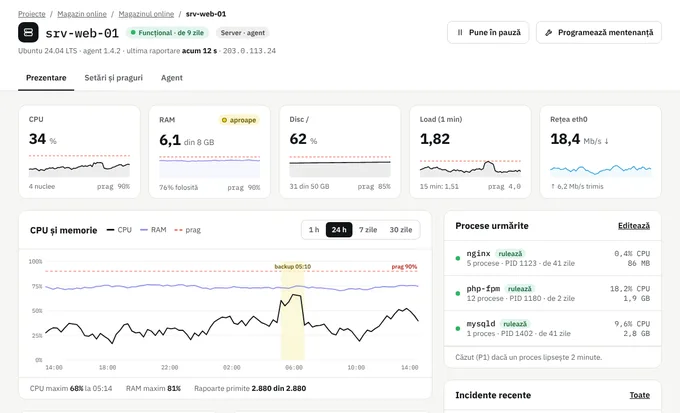
CPU, memorie, disc și procese, de la un agent instalat cu o comandă.
FuncționalitateIncidente
Fiecare cădere confirmată devine un incident cu cronologie, priorități și confirmare.
ProdusPagini de status
Serviciile tale, pe o pagină publică cu istoric de 90 de zile și abonare.
Întrebări
Despre monitorizare
De unde verificați?
Din Frankfurt, singura regiune activă la lansare. București, Amsterdam, Londra, Virginia și Singapore apar „În curând”. Când pornește a doua regiune, confirmarea din cel puțin 2 regiuni se face automat. IP-urile de pe care verificăm sunt în Setări › IP-uri, pentru whitelisting.
Cât de des verificați?
Intervalul minim depinde de plan: Gratuit la 5 min, Start la 1 min, Echipă la 30 s, Agenție la 30 s. Intervalul se alege pe fiecare verificare, dintre cele ale planului.
Ce înseamnă o verificare critică?
Verificările critice decid starea serviciului și ce apare pe pagina de status. O verificare necritică (de exemplu un endpoint intern) își arată starea în consolă, dar nu deschide incidente și nu marchează serviciul ca picat.
Cum funcționează heartbeat-ul?
Primești un URL unic (onduty.ro/hb/…). Scriptul tău îl apelează când termină; dacă semnalul nu vine în intervalul așteptat plus toleranța aleasă, deschidem un incident. Verificările heartbeat sunt pe Start și peste.
Pot opri alertele cât lucrez pe server?
Da, cu o fereastră de mentenanță. Verificările continuă să ruleze și să se înregistreze, dar nu deschid incidente și nu sună pe nimeni.
Pune prima verificare în 30 de secunde
Plan gratuit, fără card. Treci pe un plan plătit când ai nevoie de apeluri și gardă.